 智慧住宅規劃
OpenAI 發布〈How AI is expanding what people do at work〉,將焦點放在 AI 如何擴張人們在工作中可處理的內容。依目前可取得的研究摘要,ChatGPT 使用者可能跨越既有角色承接更多任務,進而使工作內容與職務邊界出現重整的可能。
這個觀察值得企業系統團隊重視,但不宜直接延伸成「AI 已經取代職務」或「導入後必然提升產出」的結論。現有輸入資料並未提供研究方法、樣本、統計數據或發布日期,因此無法據此判定影響規模,也不能將個別使用情境推論為普遍成效。較可靠的企業問題是:當員工可以更容易取得跨領域協助時,哪些任務可以安全地下放、哪些決策仍須保留專業責任,以及既有系統是否能承受新的資料與流程流動。
AI 擴張的不是職稱,而是可執行任務的範圍
傳統企業分工常以部門、職稱與系統權限劃出邊界。例如,業務人員提出需求、營運人員整理規則、工程團隊實作介接、法務或資安單位審核例外。這些邊界並不只是組織習慣,也反映了專業判斷、資料可見性與責任歸屬。
生成式 AI 介入後,第一個變化通常不是組織圖立即改寫,而是單一工作者可以更快形成跨域工作的「第一版」。非工程角色可以整理 API 需求草稿、解讀錯誤訊息或提出測試案例;工程人員則能將會議內容轉為規格初稿、彙整多份技術文件,或協助釐清流程中的例外條件。這些行為不等同於角色專業被抹除,而是降低了開始處理陌生任務的門檻。
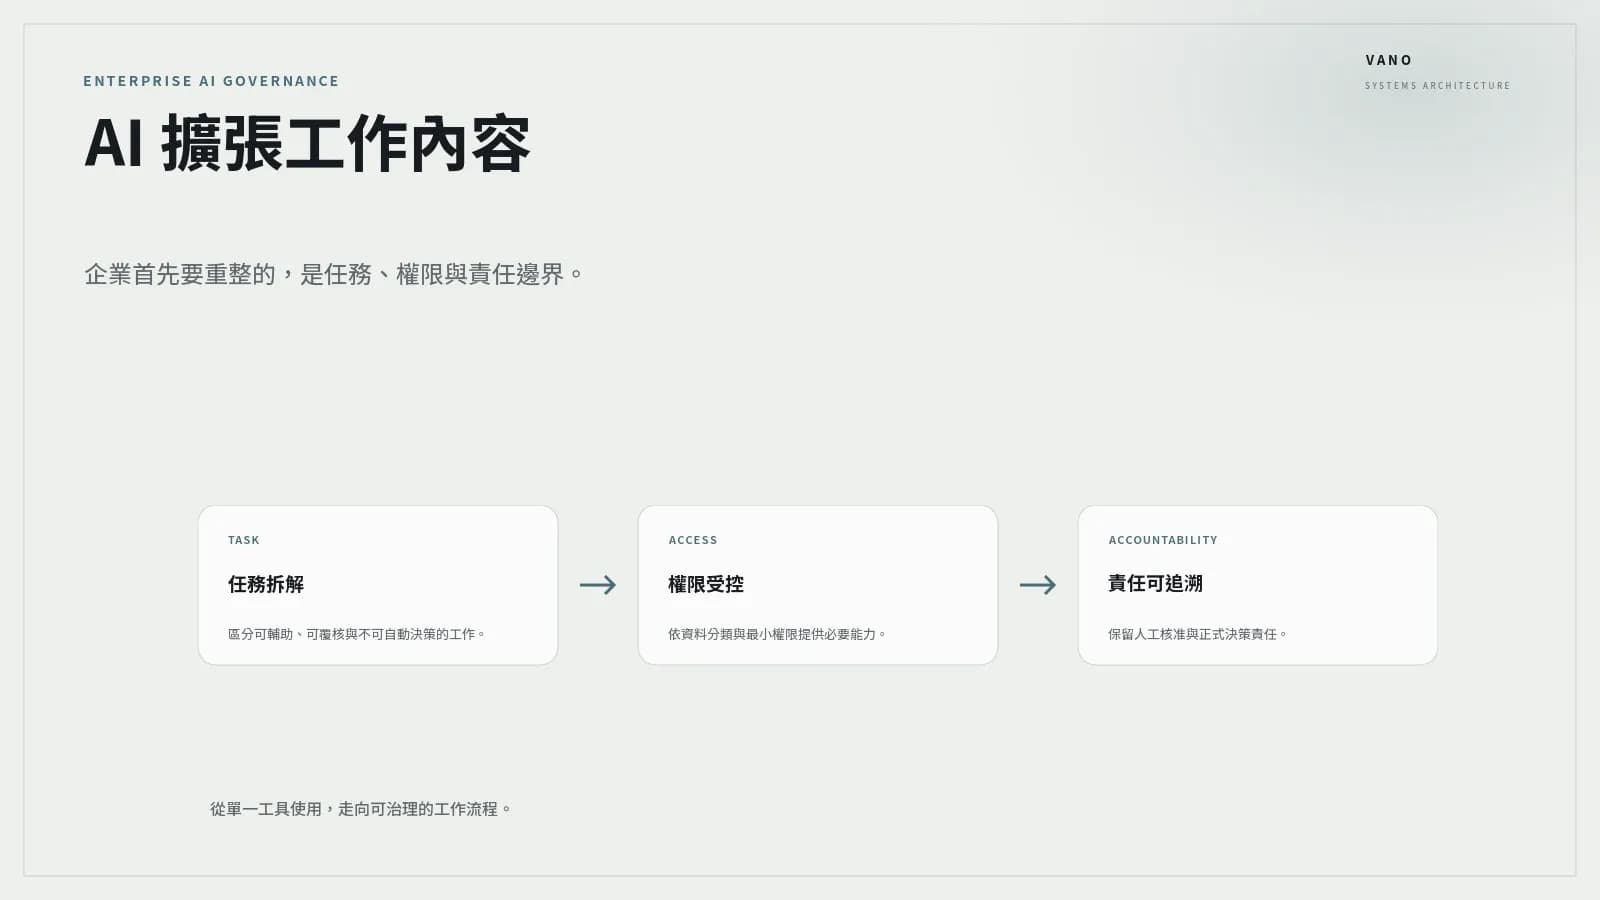
因此,企業不應以「哪些人可以使用 AI」作為唯一治理分類,而要辨識「哪些任務可由 AI 輔助完成」。一項任務若只涉及公開資訊、可重複檢查的格式轉換,且結果可由原流程快速覆核,通常比涉及個資、商業機密、交易核准或正式決策的工作更適合先行導入。任務層級的判斷,比以職稱一刀切更接近實際風險。
先拆解任務,再討論職務邊界如何調整
若企業直接以「讓每個人都用 AI」作為推動方式,常會遇到兩種問題:一是使用者能產出看似完整的內容,卻不清楚資料來源與責任界線;二是原本分散在不同系統與部門的控制點,被一次對話或一次自動化流程繞過。
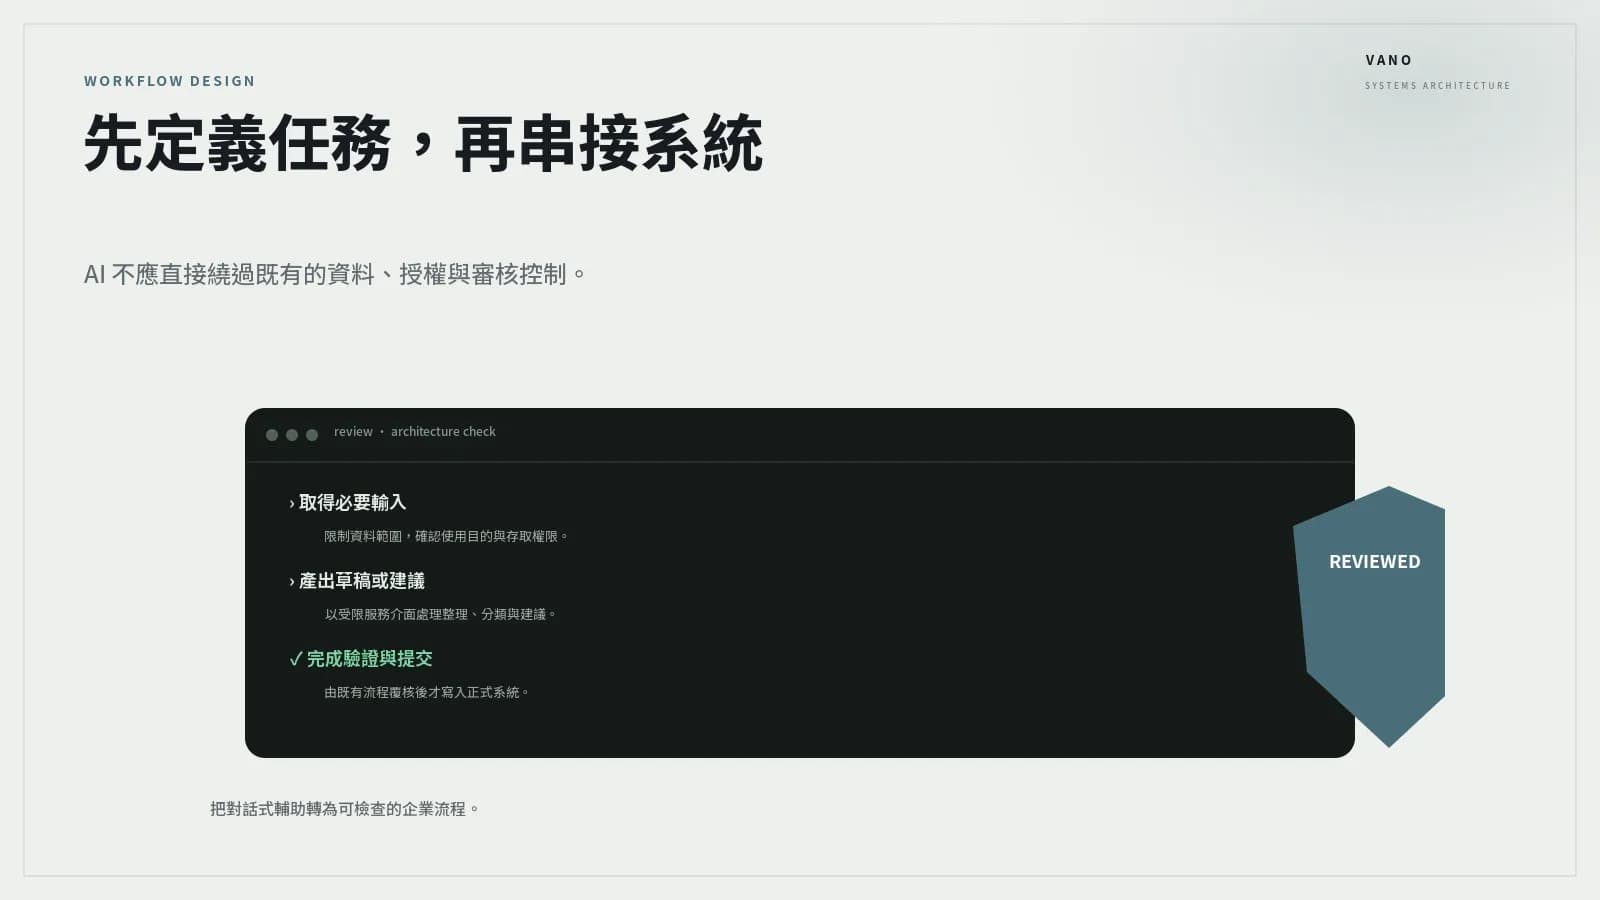
較穩健的做法,是將工作拆成可檢視的任務單元。每個單元至少應回答四個問題:輸入資料從何而來、AI 被允許做什麼、誰負責驗證輸出、結果會影響哪一個正式系統或決策。以採購流程為例,AI 可協助把內部需求整理成詢價草稿,但不應自行取得供應商主檔、替代人工核准,或直接建立付款指示。前者是內容整理;後者則涉及資料權限、交易責任與稽核紀錄。
職務邊界的調整,也應建立在這類拆解上。可以把責任區分為三層:第一層是資訊彙整與草稿生成;第二層是領域人員的事實核對與判斷;第三層是具有法定、財務、資安或營運責任的正式核准。AI 可以協助前兩層提高可處理範圍,但不應模糊第三層的責任主體。這樣的設計不是為了限制工具,而是確保跨角色協作仍能追溯。
多系統整合決定 AI 能否從對話走進流程
許多 AI 使用仍停留在個人對話視窗:使用者複製資料、詢問問題,再將答案貼回文件或系統。這種方式雖然容易開始,卻也容易產生版本不一致、人工轉抄錯誤與資料外流風險。當企業希望將 AI 使用延伸至正式工作流時,核心課題就會轉為系統整合。
成熟的整合不應讓模型直接成為所有系統的高權限操作者,而應由既有企業服務層提供受控能力。例如,透過明確定義的 API 或服務介面,讓 AI 只能查詢必要欄位、建立待審核草稿,或提出符合規則的下一步建議。正式寫入 ERP、CRM、工單、檔案庫或身分系統前,仍應經過既有授權、驗證與紀錄機制。
對 Apple 平台為主的企業環境而言,這也意味著 macOS、iOS 與 iPadOS 上的使用體驗,不能脫離企業身分、裝置管理與後端服務治理而獨立規劃。員工可能從行動裝置發起工作、在桌面環境補充資訊,再由內部系統完成審核。設計重點不是讓每個裝置各自接上一個 AI 服務,而是讓不同裝置在相同的帳號、權限、資料分類與稽核原則下工作。
安全開發的重點,是限制能力而非只限制提問
企業討論 AI 安全時,容易把重點集中於提示詞規範,例如禁止輸入機密資料。這是必要的第一步,但不足以處理 AI 進入工作流程後的風險。真正需要設計的是:系統允許 AI 取得什麼資料、可呼叫哪些功能、哪些動作一定要由人確認,以及出現異常時如何停止與追查。
在實作上,可將 AI 相關功能視為一個受限的應用程式元件,而不是可信任的人類使用者。其服務帳號應採取最小權限;資料查詢應限制範圍與用途;可執行動作應區分為讀取、草稿建立與正式提交;每次重要呼叫都要保留足以稽核的事件紀錄。對涉及個資、健康資訊、財務資料或受合約限制內容的情境,更應先確認資料分類、保存政策與對外傳輸條件,再決定是否納入 AI 流程。
安全開發同時需要接受一項現實:模型輸出可能有誤、可能遺漏脈絡,也可能以看似合理的文字掩蓋不確定性。因此,系統設計不宜假設 AI 回答必然正確,而應將驗證設計為流程的一部分。例如,對來源要求、規則比對、人工覆核與例外處理,都應在介面與後端流程中有明確位置,而非僅寫在使用守則裡。
長期維運比一次性展示更能檢驗價值
AI 應用的初期展示,往往能快速呈現摘要、分類或草稿生成效果;真正困難的部分則在後續維運。企業需要持續面對模型與服務版本變動、提示詞調整、資料結構改版、權限異動、使用者教育,以及制度與稽核要求的更新。若沒有明確擁有者,原本局部使用的工具很容易變成難以盤點的影子流程。
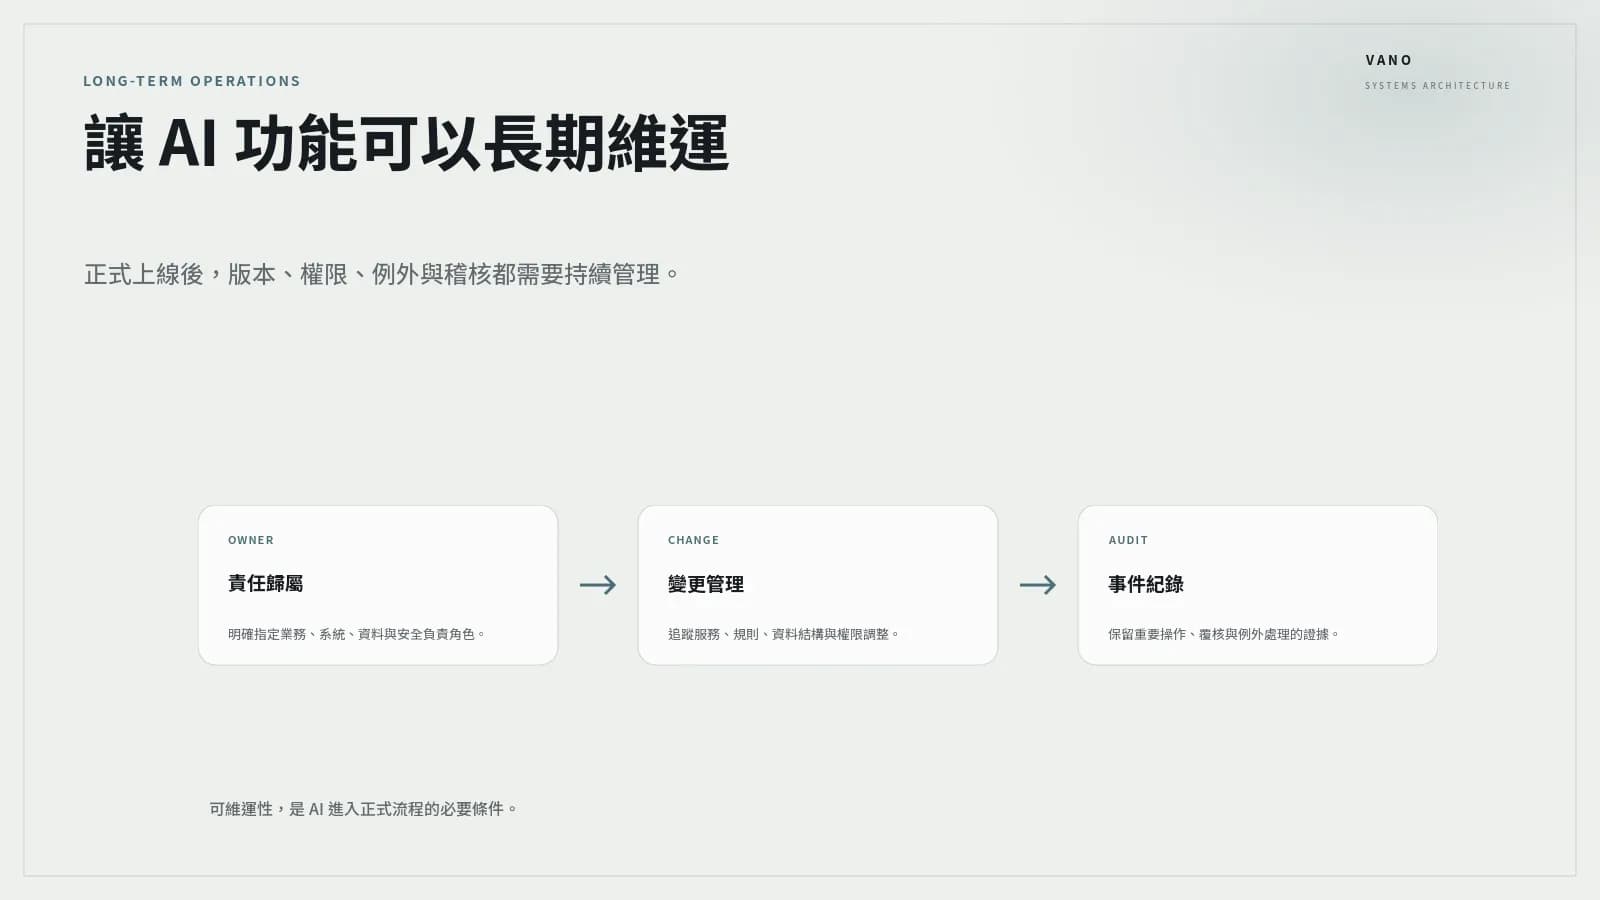
因此,應將 AI 功能納入既有應用生命週期管理,而非另設一套無法交接的實驗機制。每個進入正式流程的使用案例,都應具備業務負責人、系統負責人、資料負責人與安全審查責任。變更時要能知道哪些流程受到影響;出現錯誤時要能回溯輸入、規則、系統版本與人工核准紀錄;停止服務時也要能安全撤除權限與保留必要的稽核證據。
衡量方式同樣應避免只看生成內容的數量。較有意義的觀察包括:任務是否縮短了等待與交接時間、人工覆核是否仍能有效發現問題、例外案件是否增加、資料存取是否符合既定規則,以及使用者是否清楚知道何時不能依賴 AI 輸出。這些指標未必能立即形成單一的效率數字,卻更能反映系統是否可長期運作。
結論:把 AI 視為重新配置責任的系統工程
OpenAI 的研究主題提示了一個值得持續觀察的方向:AI 可能讓人們跨越既有角色處理更多工作內容。不過,對企業而言,重要的不是急著重新命名職位,也不是把每一個流程都接上模型,而是先建立可治理的任務邊界。
可先從資料風險較低、輸出可被快速驗證、且不直接造成正式交易或權利義務的任務開始;再逐步將身分驗證、權限控管、系統介接、人工核准與稽核紀錄納入設計。當 AI 從個人輔助工具走進跨系統流程,企業真正需要維護的不是一段提示詞,而是一套清楚、可驗證、可回復且可長期維運的責任架構。